IA em engenharia reversa: o que ela faz bem e onde intervim
IA engenharia reversa virou tema fácil de hype vazio — "a IA faz tudo", "a IA ainda não faz nada", polos extremos sem substância. No WS-engine, trabalhei meses com Claude Code em engenharia reversa de protocolo binário desconhecido e aprendi onde a IA é força multiplicadora real e onde eu precisei p
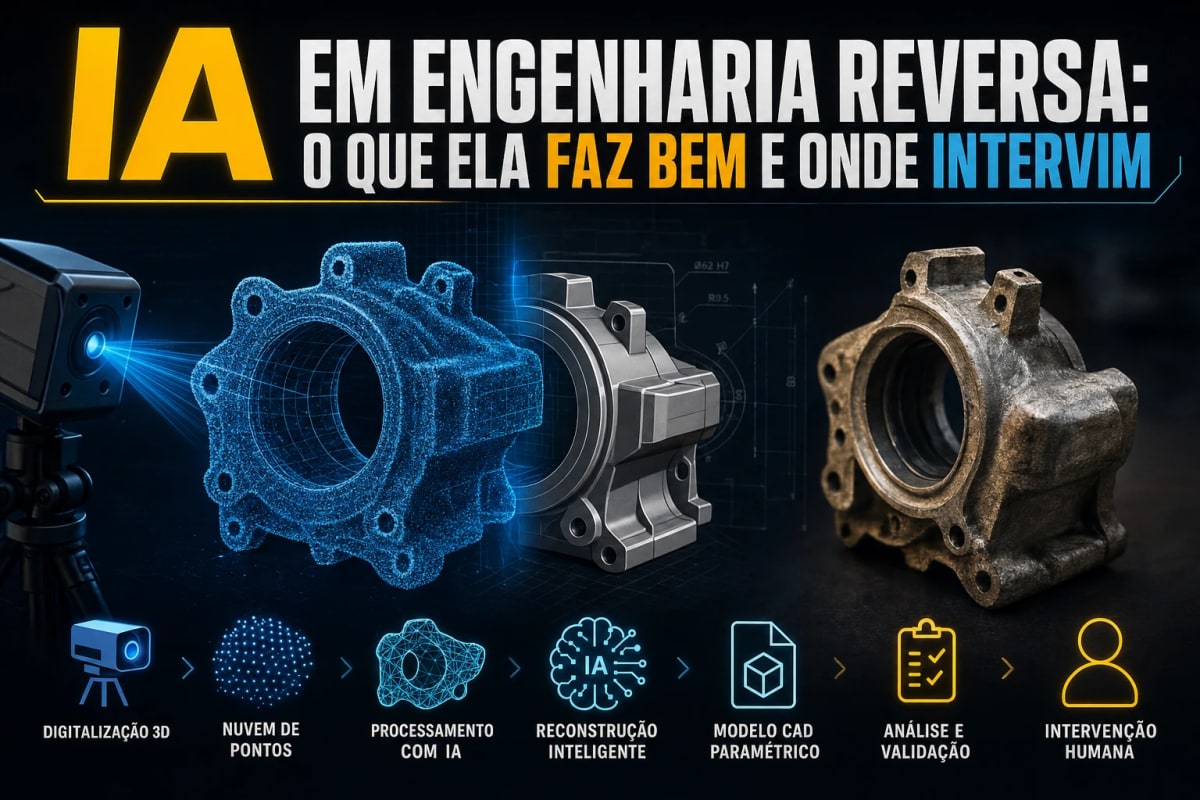
IA engenharia reversa virou tema fácil de hype vazio — "a IA faz tudo", "a IA ainda não faz nada", polos extremos sem substância. No WS-engine, trabalhei meses com Claude Code em engenharia reversa de protocolo binário desconhecido e aprendi onde a IA é força multiplicadora real e onde eu precisei puxar o freio com domain knowledge humano. Este artigo lista exemplos concretos do que ela fez bem e onde intervim. Pra contexto maior, veja o guia de engenharia reversa com IA.
A pergunta certa: onde a IA é força multiplicadora e onde é distração
Discussão improdutiva: "a IA é boa ou ruim pra RE?". Discussão produtiva: "em qual momento específico do fluxo de RE ela acelera, em qual atrapalha?". A segunda pergunta tem resposta útil porque força especificidade. A primeira produz debate religioso sem conclusão.
No meu caso, a resposta ficou clara depois de alguns meses: IA engenharia reversa é força multiplicadora em tarefas repetitivas de volume (ler hex, correlacionar padrões, propor hipóteses em paralelo), neutra em tarefas que exigem padrão de código específico do projeto, e distração em decisões que dependem de conhecimento de domínio que ela não tem. Nenhuma dessas é absoluta — mas o padrão aparece de forma consistente ao longo das sessões.
Ler hex em volume sem fadiga é um superpoder específico
Essa resistência a fadiga é a vantagem mais concreta da IA em RE. Olhar hexdump de 500 bytes procurando padrão específico é tarefa que cansa humano em cinco minutos. A atenção se perde, o padrão foge, o olho começa a ignorar partes. A IA não tem esse limite. Posso jogar 2000 bytes num hexdump e pedir "procura sequências repetitivas de 4 bytes com padrão X" — ela faz, lista as ocorrências, não reclama.
Esse tipo específico de resistência à fadiga é onde ela mais acelerou meu trabalho de IA engenharia reversa. Capturas de referência do WS-engine têm às vezes centenas de milhares de bytes. Procurar manualmente seria dias de trabalho; com a IA como par, fica em alguns minutos de prompt bem feito.
Inferir layout de struct a partir de magnitude dos valores
Quando uma struct binária tem campos de significado desconhecido, uma técnica útil é olhar a magnitude dos valores em várias amostras. Timestamp Unix em segundos cabe em 10 dígitos decimais; em milissegundos cabe em 13. Contador de 32 bits raramente passa de 10 mil em sessão curta. Posição no mapa tem range típico específico do jogo.
A IA é boa em correr essas comparações cruzadas automaticamente. Dei a ela 50 instâncias de uma mesma struct e perguntei "quais campos parecem ser timestamps, contadores ou identificadores baseado em magnitude e variabilidade?". Ela voltou com classificação candidata que serviu de base pra testes direcionados. Essa inferência de layout por magnitude é padrão em IA engenharia reversa e economiza horas de hipótese às cegas.
Nomear função a partir do contexto do call site
Em código que vem sem símbolos (binário stripped), funções aparecem como sub_401234 ou similar. Nomear essas funções é um trabalho criativo de descoberta — você olha onde ela é chamada, o que faz antes e depois, e propõe um nome que capture a intenção. Humano faz bem, mas devagar. IA faz rápido quando tem o call site completo em mãos.
No WS-engine, usei isso pra batizar funções do decoder. Mostrava pra IA o trecho de código que chamava a função desconhecida, o contexto antes e depois, o valor de retorno. Ela propunha dois ou três nomes candidatos. Eu escolhia. O ganho não é a nomenclatura final (que ainda passa pelo meu filtro) — é economizar o esforço mental de gerar as opções.
Confusão de domínio: dano real vs reflexo (precisava eu intervir)
Primeiro exemplo onde a IA falhou e precisei intervir: distinguir dano direto de dano refletido. No jogo, quando um atacante bate num alvo com buff de reflexão ativo, parte do dano volta pro atacante. Isso aparece no stream como dois eventos de dano próximos no tempo, com atacante e alvo invertidos.
Pedi pra IA diferenciar "dano causado" e "dano recebido" no decoder. Ela propôs lógica puramente baseada em flag de evento. Problema: a flag não distingue o reflexo. Pra separar, precisa saber que personagem X tem buff de reflexão ativo naquele instante, cross-referenciar com eventos de buff anteriores, aplicar heurística temporal. Isso exige entender a mecânica do jogo. A IA não tinha esse conhecimento; eu tive que trazer e explicitar como regra no código.
Refator que ignora história do código: dizer não ao "pattern Factory"
Segundo exemplo onde intervim: a IA tende a propor refatoração de padrão quando o código parece "feio". Um decoder específico que escrevi inline, por motivo de performance, foi algumas vezes alvo de sugestão "vamos extrair isso como Factory pattern". Padrão clássico de livro, teoricamente limpo, prático desastre pro caso específico.
O decoder roda milhões de vezes por sessão. Cada alocação de objeto custa. Factory pattern aqui multiplicaria alocação. A IA sugeriu três vezes em três sessões diferentes — toda vez eu precisei explicar o contexto de performance pra abortar a mudança. Essa classe de sugestão genérica em cima de código específico é um padrão de risco em IA engenharia reversa quando a IA não tem contexto de histórico do código.
Otimização premature: onde a IA pode piorar performance
Esse padrão de proposta genérica é a parte mais recorrente de falha em IA engenharia reversa aplicada a projeto maduro. Terceiro exemplo: a IA tem viés pra micro-otimização de código que parece "lento" sem olhar onde o gargalo real está. Já me propôs trocar Dictionary<,> por SortedList<,> em código que executa dez vezes por segundo — mudança que teoricamente poupa alocação mas na prática não aparece em profile.
O gargalo real do WS-engine era alocação de buffer no reassembly, não a estrutura de hash. Quando apontei isso, a IA conseguiu propor fix no lugar certo — mas sozinha ela ia pra micro-otimização genérica. Essa falta de intuição sobre onde a performance realmente sangra é lacuna frequente. A IA é boa em aplicar otimização quando você aponta o alvo; é fraca em escolher o alvo. A regra que aprendi: dizer explicitamente onde está o gargalo real antes de pedir otimização. Sem esse direcionamento, a IA aplica receita padrão de livro que raramente é a certa pro caso específico. Com ele, a sugestão fica cirúrgica. Pra ver o projeto completo em produção, dá uma volta no ModoDev.
Avalie este artigo
Continue lendo
 Inteligência Artificial
Claude Fable 5 Artifacts: Colaboração em Tempo Real
Vou escrever o artigo baseado nas informações encontradas sobre Claude Artifacts. Note que não encontrei referências específicas a "Claude Fable 5" - isso…
 Inteligência Artificial
Antivírus falso positivo em .exe: por que acontece
antivírus falso positivo em executável próprio é a experiência mais frustrante de quem distribui software pequeno pelo Windows. Compilei, testei, mandei pra um…
 Inteligência Artificial
Supabase como backend anônimo para app desktop
Supabase app desktop parece casamento improvável — Supabase é geralmente associado a apps web, não a executáveis WinForms rodando no computador do usuário. No…
Comentários
Carregando comentários...