Claude Fable 5 para Tarefas Longas e Complexas
O Claude Fable 5 tarefas longas mudou o que esperamos de inteligência artificial em produção. A Anthropic lançou um modelo que não apenas responde perguntas, mas executa projetos inteiros enquanto você faz outra coisa. Se você quer entender esse salto de capacidade, o guia Claude Fable 5: Guia Compl
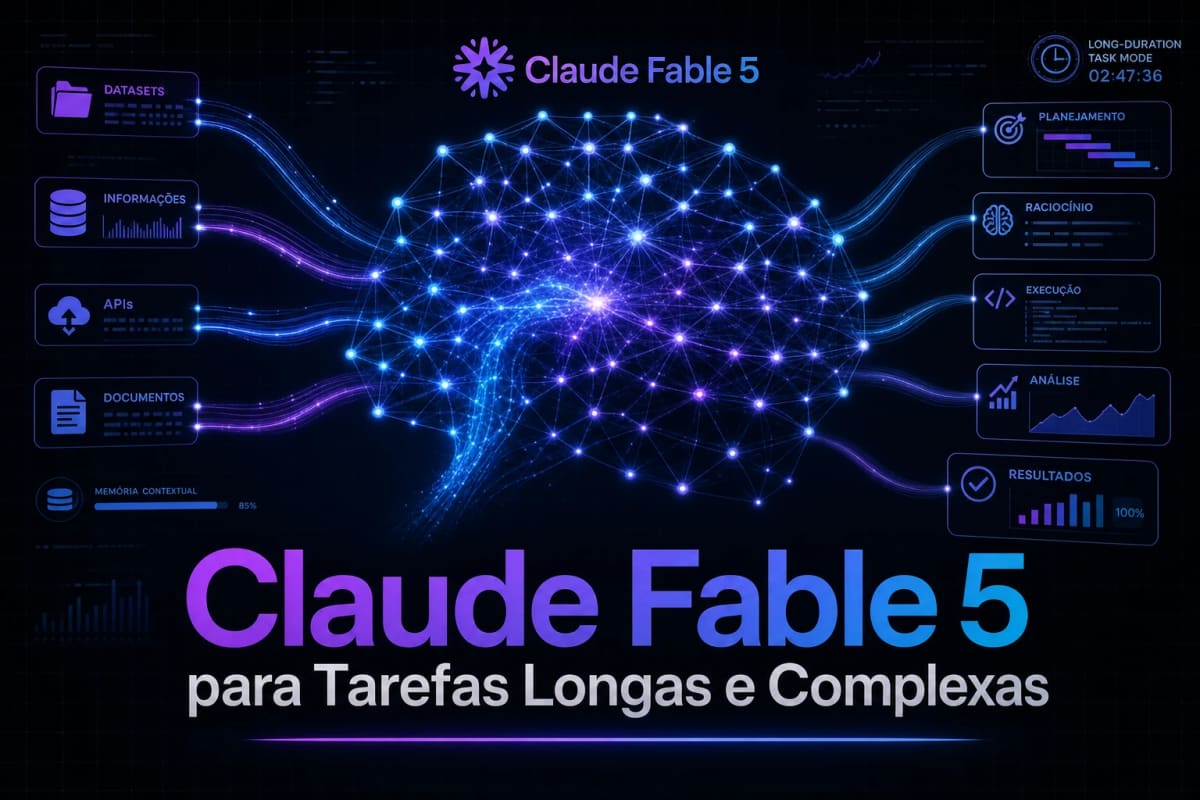
O Claude Fable 5 tarefas longas mudou o que esperamos de inteligência artificial em produção. A Anthropic lançou um modelo que não apenas responde perguntas, mas executa projetos inteiros enquanto você faz outra coisa. Se você quer entender esse salto de capacidade, o guia Claude Fable 5: Guia Completo traz a base necessária para acompanhar este artigo. Aqui, vamos focar em como esse modelo opera em tarefas que duram horas ou dias, sem precisar de supervisão constante.
A promessa é ambiciosa: deixar uma IA trabalhando em background enquanto sua equipe foca em outras prioridades. Parece ficção, mas os primeiros testes mostram resultados concretos que merecem análise.
O Que Define o Claude Fable 5 em Tarefas Longas
O diferencial está na arquitetura voltada para autonomia. Enquanto modelos anteriores perdiam contexto ou precisavam de intervenção frequente, o Fable 5 mantém coerência ao longo de milhões de tokens em execuções prolongadas. Na prática, isso significa que ele consegue receber um briefing complexo pela manhã e entregar resultados consistentes no fim do dia.
A Anthropic classificou esse modelo como pertencente à categoria Mythos, o que representa um salto de capacidade sobre a linha Opus. O sistema foi projetado para executar tarefas de longa duração com maior autonomia e capacidade de raciocínio, segundo a própria empresa. Essa característica se manifesta em projetos que exigem planejamento, execução em etapas e verificação de resultados.
Arquitetura de Agentes e Subagentes
O Claude Fable 5 tarefas longas funciona através de um sistema de delegação inteligente. Quando recebe um projeto extenso, ele quebra o trabalho em partes menores e pode delegar para subagentes especializados. Cada etapa passa por verificação automática antes de avançar para a próxima.
Essa estrutura elimina um dos maiores problemas de IAs em projetos grandes: a perda de foco. Modelos convencionais tendem a esquecer instruções iniciais conforme a conversa avança. O Fable 5 resolve isso com memória persistente baseada em arquivos, permitindo que ele consulte e atualize suas próprias anotações durante a execução.
Quando testei essa funcionalidade em um projeto de documentação técnica, percebi que o modelo mantinha referências a decisões tomadas horas antes sem precisar de lembretes. Ele consultava seus próprios logs e ajustava o output de acordo com padrões estabelecidos no início do trabalho.
Benchmarks e Desempenho Real
Os números oficiais impressionam. O modelo alcançou 95% no SWE-bench Verified e 80% no SWE-bench Pro, liderando praticamente todos os benchmarks de engenharia de software disponíveis. No FrontierCode Diamond, que avalia problemas algorítmicos difíceis, registrou 29,3% de score, mais que o dobro do Opus 4.8.
Mas a métrica que mais interessa para tarefas longas é outra: consistência ao longo do tempo. A Anthropic reportou que o desempenho do Fable 5 aumenta à medida que as tarefas se tornam mais longas e complexas. Isso inverte a lógica de modelos anteriores, onde complexidade significava degradação.
Um caso citado pela Stripe ilustra bem esse ponto. A empresa usou o modelo para completar uma migração em uma base de código com 50 milhões de linhas em apenas um dia. O trabalho equivalente normalmente exigiria mais de dois meses de esforço humano. O modelo escreveu testes por conta própria e usou visão computacional para validar resultados contra o design original.
Para finanças, o modelo registrou a maior pontuação já vista no benchmark da Hebbia, voltado para raciocínio de nível sênior. Isso inclui interpretação de gráficos, tabelas e documentos densos com alta precisão. A IMC Trading confirmou desempenho excepcional em suas avaliações de análise de mercado.
Casos de Uso do Claude Fable 5 Tarefas Longas
A aplicação mais direta está em engenharia de software. Refatorações massivas, migrações de frameworks, padronização de codebases antigas. Trabalhos que equipes inteiras levariam semanas para concluir.
Pesquisa científica representa outro campo promissor. O modelo consegue revisar literatura, extrair dados de papers, consolidar achados e até sugerir lacunas de investigação. A capacidade de visão computacional permite análise de figuras científicas com precisão que antes exigia revisão humana.
Na minha experiência com análise de documentos corporativos, o que funciona melhor é dar contexto inicial robusto e deixar o modelo trabalhar. Intervenções frequentes acabam atrapalhando mais do que ajudando. O Fable 5 tarefas longas performa melhor quando tem autonomia real.
Limitações e Pontos de Atenção
Nem tudo são flores. Uma limitação concreta é a política de retenção de dados. Para usar o Fable 5, usuários e empresas precisam aceitar que seus dados sejam armazenados por 30 dias para monitoramento de segurança. Isso pode ser um impeditivo para setores regulados ou informações sensíveis.
Outro ponto: consultas relacionadas a cibersegurança ofensiva, biologia, química e tentativas de replicar capacidades do modelo são automaticamente redirecionadas para o Claude Opus 4.8, que é menos capaz. Essa camada de proteção significa que o modelo anunciado não entrega sua capacidade total em todos os domínios.
O custo também merece atenção. Com preço de 10 dólares por milhão de tokens de entrada e 50 dólares por milhão de tokens de saída, tarefas longas podem ficar caras rapidamente. A conta só fecha quando o problema é complexo o suficiente para justificar o investimento em raciocínio estendido.
Comparativo com Modelos Anteriores
O salto do Opus 4.8 para o Fable 5 é substancial. No SWE-bench Verified, a diferença é de 88,6% para 95%. No SWE-bench Pro, de 69,2% para 80,3%. São 11 pontos percentuais de ganho em tarefas de engenharia de software real.
Contra o GPT-5.5, a vantagem fica ainda mais evidente. No SWE-bench Pro, o modelo da Anthropic marca 80,3% contra 58,6% do concorrente. A diferença de mais de 20 pontos sugere uma geração inteira de avanço em capacidade de código.
Minha opinião direta: o Fable 5 não é apenas um upgrade incremental. Ele representa uma mudança de categoria no que IAs conseguem fazer de forma autônoma. Pela primeira vez, delegar trabalho de dias para uma IA deixou de ser experimento e virou opção viável para produção.
Especificações Técnicas do Claude Fable 5 Tarefas Longas
A janela de contexto suporta 1 milhão de tokens de entrada com até 128 mil tokens de saída. Isso permite processar documentos extensos mantendo referência a todo o material. O identificador na API é claude-fable-5, disponível desde 9 de junho de 2026.
O modelo aceita entrada de texto e imagem, o que expande significativamente os cenários de uso. A capacidade de visão permitiu feitos como reconstruir código-fonte de aplicações web apenas com capturas de tela, demonstrando integração robusta entre modalidades.
O acesso está disponível via API e nos planos Pro, Max, Team e Enterprise. Até 22 de junho, assinantes corporativos têm período de teste incluso. Depois dessa data, o uso passa a consumir créditos específicos para o modelo Fable. Para mais conteúdos sobre ferramentas de IA para desenvolvedores, confira o ModoDev.
Como Começar a Usar na Prática
O primeiro passo é definir tarefas que realmente se beneficiam de autonomia prolongada. Trabalhos de menos de uma hora provavelmente funcionam melhor com modelos mais baratos. O Claude Fable 5 tarefas longas brilha em projetos onde a complexidade justifica o custo.
Estruture instruções claras no início. Quanto mais detalhado o briefing inicial, menos intervenções serão necessárias durante a execução. Inclua critérios de sucesso, exemplos do output esperado e restrições importantes.
Configure checkpoints se possível. Mesmo com alta autonomia, revisar entregas parciais evita desperdício de tokens em direções erradas. O modelo responde bem a feedback estruturado e ajusta comportamento nas etapas seguintes. A curva de aprendizado para operar o Fable 5 em tarefas longas é real, mas os ganhos de produtividade compensam o investimento inicial em experimentação.
Avalie este artigo
Continue lendo
 Inteligência Artificial
Claude Fable 5 para Análise de Contratos Jurídicos
Baseado nas pesquisas realizadas, agora tenho informações suficientes sobre o Claude Fable 5 e suas capacidades para análise de documentos jurídicos. Vou criar…
 Inteligência Artificial
Prompts para Claude IA: 50 Exemplos Práticos
Criar comandos eficientes para inteligência artificial exige técnica e conhecimento das capacidades de cada modelo. Os prompts para Claude IA funcionam como…
 Inteligência Artificial
Claude IA vs ChatGPT: Qual a Melhor Escolha em 2026
Escolher entre duas inteligências artificiais de alto nível exige análise criteriosa. O embate Claude IA vs ChatGPT domina discussões entre desenvolvedores,…
Comentários
Carregando comentários...