Safeguards do Claude Fable 5: Entenda as Limitações
Os classificadores de segurança do Claude Fable 5 safeguards representam uma mudança significativa na forma como a Anthropic gerencia modelos de IA com capacidades avançadas. Se você trabalha com desenvolvimento, pesquisa ou qualquer área técnica que envolva o Fable 5, entender esse sistema é essenc
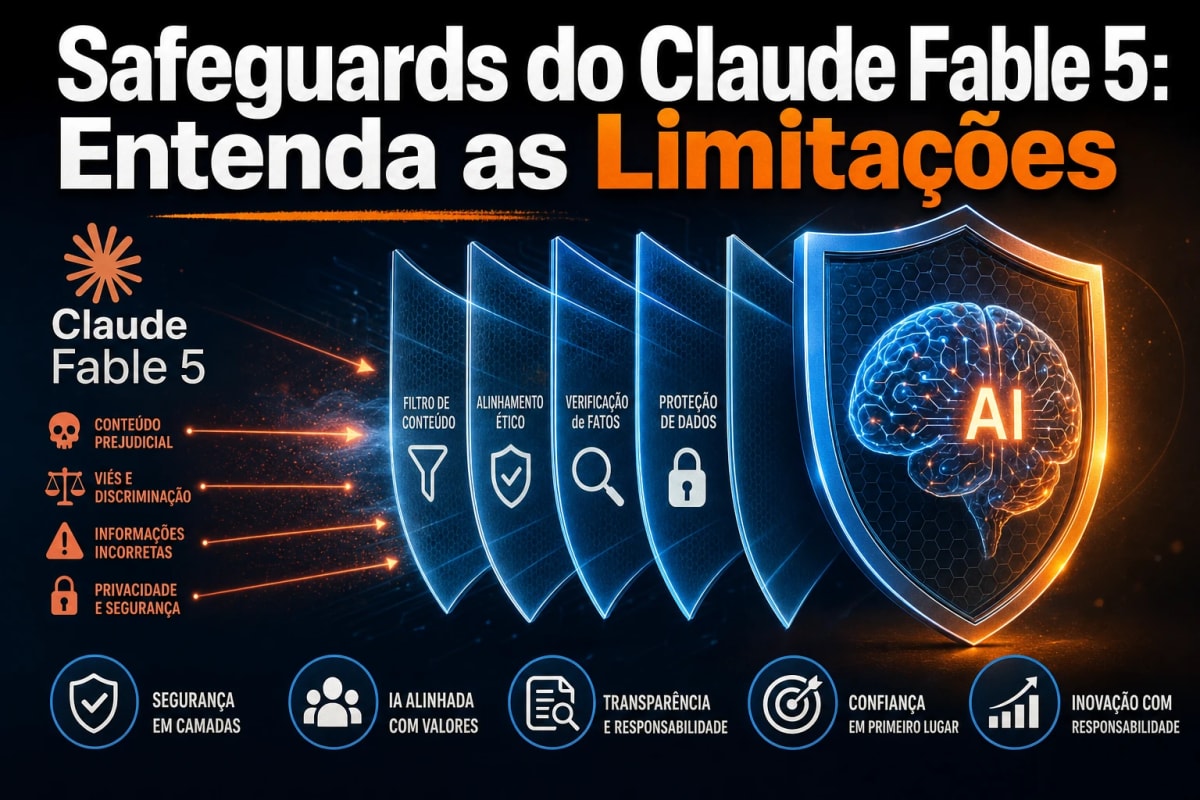
Os classificadores de segurança do Claude Fable 5 safeguards representam uma mudança significativa na forma como a Anthropic gerencia modelos de IA com capacidades avançadas. Se você trabalha com desenvolvimento, pesquisa ou qualquer área técnica que envolva o Fable 5, entender esse sistema é essencial para evitar surpresas durante o uso diário. O Claude Fable 5: Guia Completo traz uma visão geral do modelo, mas aqui vamos mergulhar especificamente no funcionamento dos mecanismos de proteção e nos cenários onde o fallback para Opus 4.8 entra em ação.
O Fable 5 compartilha sua base com o Claude Mythos 5, que a Anthropic considera o modelo com as capacidades mais avançadas em cibersegurança disponíveis. A diferença entre eles está justamente na camada de salvaguardas que permite ao Fable 5 ser acessível ao público geral.
Como Funcionam os Classificadores de Segurança
Os Claude Fable 5 safeguards operam através de sistemas de IA separados que analisam cada requisição antes dela chegar ao modelo principal. Esses classificadores detectam padrões associados a usos potencialmente prejudiciais, incluindo tentativas de jailbreak. Quando um classificador identifica uma requisição como sensível, o modelo não simplesmente recusa responder.
Em vez de bloquear completamente, o sistema redireciona a consulta para o Claude Opus 4.8. Esse modelo ainda oferece respostas competentes, mas sem as capacidades de nível Mythos que poderiam ser mal utilizadas. O usuário é notificado quando isso acontece na interface do Claude.ai.
Na minha experiência, esse redirecionamento acontece de forma transparente. Em um momento você está conversando com Fable 5, e no próximo, sem aviso prévio durante a resposta, percebe que foi transferido. Só depois a notificação aparece.
As Três Categorias que Acionam o Fallback
Os classificadores do Claude Fable 5 safeguards monitoram três domínios específicos. O primeiro é cibersegurança ofensiva: técnicas de construção de exploits, malware ou ferramentas de ataque. O segundo abrange biologia e química, especialmente métodos laboratoriais ou mecanismos moleculares que possam ser aplicados de forma nociva. O terceiro é a prevenção de destilação, que bloqueia tentativas de extrair as capacidades do modelo para treinar sistemas concorrentes.
A Anthropic identificou anteriormente tentativas em larga escala de extrair as capacidades do Claude para treinar modelos em países autoritários. A destilação do Fable 5 poderia indiretamente levar à proliferação de capacidades de IA próximas à fronteira tecnológica, e essas poderiam ser liberadas sem as salvaguardas apropriadas.
Quando os classificadores detectam padrões que sugerem destilação, como reescrita de prompts em massa, uso de vetores de direcionamento ou fine-tuning eficiente em parâmetros (PEFT), a requisição também é redirecionada para o Opus 4.8. Isso representa uma mudança em relação à abordagem anterior, que dependia principalmente dos Termos de Serviço e de processos legais.
Taxa de Acionamento e Impacto Real
A Anthropic reporta que os Claude Fable 5 safeguards são acionados em menos de 5% das sessões em média. Isso significa que mais de 95% dos usuários nunca encontram o fallback durante o uso normal. Para desenvolvimento de software convencional, como aplicações web, APIs, pipelines de dados e apps mobile, as salvaguardas simplesmente não ativam.
No entanto, alguns usuários relatam experiências diferentes. Em benchmarks como o Terminal-Bench, que testa tarefas reais de linha de comando, cerca de 20,9% das tentativas do Fable 5 acionaram recusas de segurança e caíram para o fallback. Essa discrepância entre a média geral e casos específicos merece atenção.
O Papel do Claude Opus 4.8 no Sistema
O Opus 4.8 não é apenas um modelo de backup qualquer. Ele oferece inteligência e confiabilidade para ser usado como modelo principal em trabalho sério de programação e conhecimento. A Anthropic posiciona o Opus 4.8 como uma opção que questiona as premissas certas, identifica seus próprios erros e resiste quando um plano não faz sentido.
Quando o fallback acontece, você ainda recebe uma resposta útil. A diferença é que não tem acesso às capacidades ofensivas de nível Mythos. Para a maioria dos casos de uso legítimos, o Opus 4.8 resolve o problema sem grandes perdas de qualidade.
Considero esse design uma escolha inteligente. Recusas absolutas frustram usuários com casos de uso legítimos. O fallback gradual mantém a experiência funcional enquanto limita riscos específicos. Claro, isso não agrada quem realmente precisa das capacidades completas para trabalho autorizado em segurança.
Comportamento Diferente na API e no Claude.ai
A forma como os Claude Fable 5 safeguards se manifestam varia conforme a interface. No Claude.ai, quando um classificador é acionado, a sessão é automaticamente roteada para o Opus 4.8 e você recebe uma notificação. O processo acontece de forma transparente, sem necessidade de intervenção.
Na API, o comportamento é diferente. Quando o acesso por token estiver disponível, um classificador acionado bloqueia a requisição e retorna uma categoria de recusa estruturada. Não existe fallback automático por padrão. O redirecionamento para Opus é opcional e precisa ser habilitado pelo desenvolvedor.
Para scripts não interativos usando claude -p, a recusa é o comportamento padrão, não o redirecionamento. Isso exige que desenvolvedores implementem lógica própria de fallback ou aceitem os bloqueios.
O Que Não Aciona os Classificadores
Os Claude Fable 5 safeguards foram calibrados para serem precisos, não abrangentes demais. Escrever código seguro, implementar autenticação, discutir melhores práticas de segurança, corrigir vulnerabilidades no seu próprio código e conversar sobre arquitetura de segurança não acionam o classificador.
Da mesma forma, perguntas gerais sobre biologia, desenvolvimento farmacêutico, bioinformática, técnicas padrão de biologia molecular e discussões sobre pesquisa médica passam sem problemas. O objetivo é bloquear o conjunto estreito de usos perigosos e deixar todo o resto intacto.
Na prática, prefiro testar prompts sensíveis em sessões separadas antes de integrá-los em fluxos de trabalho críticos. Isso evita surpresas quando estou no meio de uma tarefa complexa.
Limitações e Falsos Positivos
A Anthropic admite que calibrou os Claude Fable 5 safeguards de forma conservadora. Isso significa que requisições inofensivas podem ser capturadas pelos classificadores. O objetivo era robustez primeiro, e falsos positivos são uma consequência aceita dessa escolha.
Para profissionais de segurança, isso cria atrito real. Desafios de CTF (capture the flag), write-ups de testes de penetração e exercícios de modelagem de ameaças tocam o mesmo vocabulário que o classificador usa para detectar riscos. A forma como o Opus 4.8 lida com esses casos geralmente melhora quando o prompt inclui contexto organizacional claro, propósito defensivo ou referências a ambientes controlados específicos.
Outra limitação relevante: repositórios que contêm material de segurança ou biologia podem acionar o classificador logo na primeira requisição de uma sessão, apenas pelo contexto do workspace. Arquivos como CLAUDE.md ou o status do git são analisados, e isso pode ser suficiente para o redirecionamento. Quando testei um repositório com documentação de pentesting, o fallback acionou antes mesmo de eu enviar qualquer pergunta.
Red-Teaming e Validação das Salvaguardas
Antes do lançamento, red-teamers externos passaram mais de 1.000 horas atacando o sistema de Claude Fable 5 safeguards. Nenhum jailbreak universal foi encontrado. Isso significa que não existe técnica confiável conhecida que remova as salvaguardas de forma consistente.
No entanto, o UK AI Safety Institute fez progresso em direção a um jailbreak durante a janela inicial de testes. Isso sugere que o sistema é robusto, mas não impenetrável. A Anthropic indica que continuará refinando os classificadores após o lançamento, tentando reduzir falsos positivos enquanto mantém a eficácia contra usos maliciosos.
Para tarefas agressivas de cibersegurança, a taxa de interceptação reportada é de 100%. Os classificadores são particularmente efetivos nesse domínio específico.
Implicações para Desenvolvedores e Empresas
Os Claude Fable 5 safeguards introduzem uma nova variável no planejamento de arquiteturas que usam o modelo. Se sua aplicação toca áreas sensíveis, você precisa decidir entre aceitar bloqueios, implementar fallback manual ou habilitar o redirecionamento automático via API.
O modelo ainda pontua 95% no SWE-bench com as salvaguardas ativas. Os benchmarks refletem a performance da versão protegida em tarefas normais de programação. Para a maioria dos desenvolvedores, isso significa que a experiência prática não será significativamente afetada. Na ModoDev, acompanhamos de perto como essas mudanças impactam fluxos de trabalho reais.
Um ponto crítico para empresas: existe agora uma política de retenção de 30 dias para todo o tráfego em modelos de classe Mythos. Mesmo que você tenha acordos de zero retenção, os Claude Fable 5 safeguards exigem essa janela para fins de segurança. Os dados não são usados para treinar novos modelos, mas a retenção obrigatória pode ser um problema para equipes em setores regulamentados.
No fim das contas, o sistema de salvaguardas representa uma tentativa genuína de equilibrar capacidade e responsabilidade. Não é perfeito, e os falsos positivos vão frustrar alguns usuários legítimos. Mas a alternativa seria ou restringir completamente o acesso público ao modelo, ou liberá-lo sem proteções. Acredito que a Anthropic fez a escolha certa ao criar esse meio-termo, mesmo que a execução ainda precise de ajustes.
Avalie este artigo
Continue lendo
 Inteligência Artificial
Claude Fable 5 para Análise de Contratos Jurídicos
Baseado nas pesquisas realizadas, agora tenho informações suficientes sobre o Claude Fable 5 e suas capacidades para análise de documentos jurídicos. Vou criar…
 Inteligência Artificial
Prompts para Claude IA: 50 Exemplos Práticos
Criar comandos eficientes para inteligência artificial exige técnica e conhecimento das capacidades de cada modelo. Os prompts para Claude IA funcionam como…
 Inteligência Artificial
Claude IA vs ChatGPT: Qual a Melhor Escolha em 2026
Escolher entre duas inteligências artificiais de alto nível exige análise criteriosa. O embate Claude IA vs ChatGPT domina discussões entre desenvolvedores,…
Comentários
Carregando comentários...