Prompt Caching no Claude Fable 5: Economize 90%
Se você está usando a API do Claude Fable 5 para projetos de desenvolvimento, integração de agentes ou automação, já percebeu que os custos de tokens podem escalar rapidamente. A boa notícia: existe uma técnica nativa que pode cortar sua conta em até 90%. Estamos falando de Claude Fable 5 prompt cac
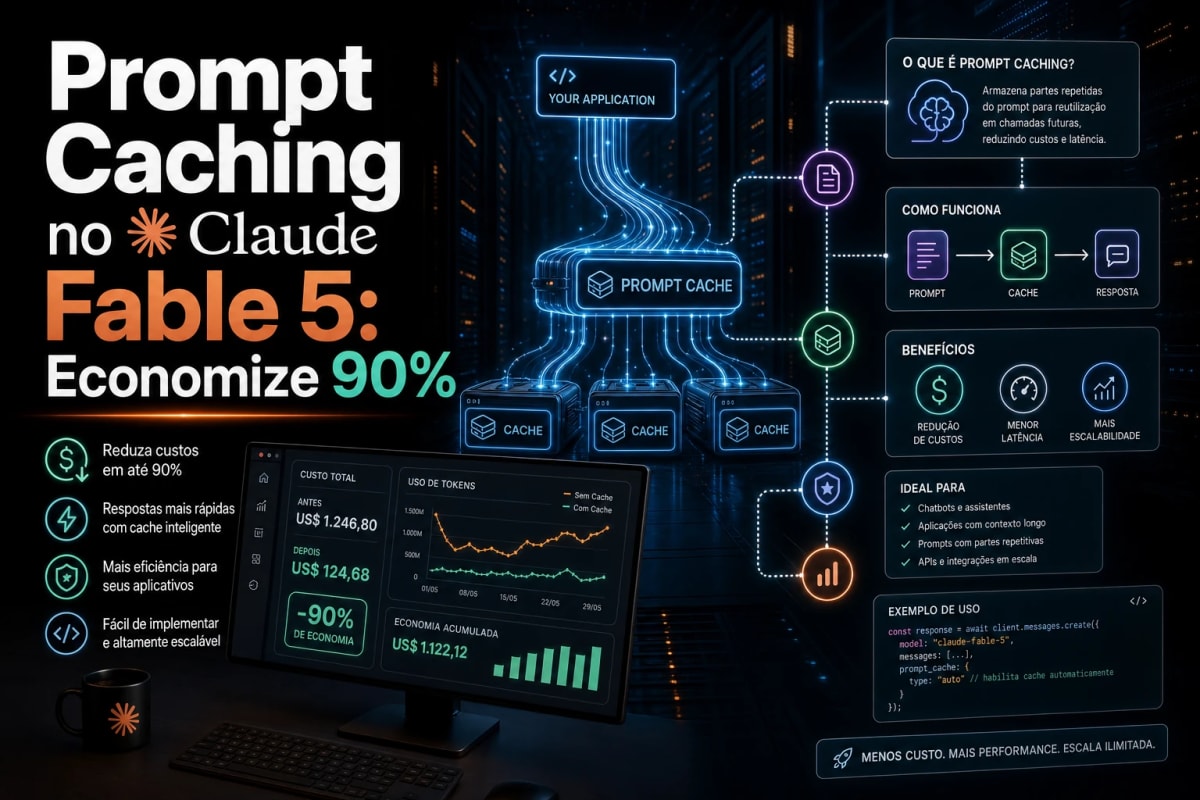
Se você está usando a API do Claude Fable 5 para projetos de desenvolvimento, integração de agentes ou automação, já percebeu que os custos de tokens podem escalar rapidamente. A boa notícia: existe uma técnica nativa que pode cortar sua conta em até 90%. Estamos falando de Claude Fable 5 prompt caching — um recurso que a maioria dos desenvolvedores ainda subutiliza. Neste artigo do Claude Fable 5: Guia Completo, você vai entender como essa funcionalidade opera, quando faz sentido aplicá-la e como estruturar seus prompts para maximizar economia real.
O que é o cache de prompts e como funciona no Claude Fable 5
O prompt caching é um mecanismo que armazena e reutiliza porções estáticas do seu prompt entre requisições. Em vez de reprocessar o mesmo system prompt, documento de referência ou histórico de conversa a cada chamada, a API recupera o conteúdo do cache por uma fração do preço normal de input.
O funcionamento depende de prefixos idênticos. A cache não é semântica — ela não interpreta que dois prompts são "parecidos". Ela verifica se o início do seu prompt é byte a byte igual ao de uma requisição anterior. Se encontrar correspondência, carrega os tensores já processados diretamente nas camadas de atenção do modelo. O Claude Fable 5 prompt caching opera exatamente assim: você paga para escrever o cache uma vez e depois lê múltiplas vezes por 10% do custo.
Estrutura de preços: cache write versus cache read
A Anthropic definiu multiplicadores específicos para o cache. A escrita inicial (cache write) no modo de 5 minutos custa 1.25x o preço base de input. Já a leitura do cache (cache read) custa apenas 0.1x — ou seja, 90% de desconto. No Claude Fable 5, que custa $10 por milhão de tokens de input, um cache hit sai por $1 por milhão.
Existe também a opção de cache de 1 hora, onde a escrita custa 2x o preço base. Nesse cenário, você precisa de pelo menos duas leituras para compensar o investimento inicial. Para a maioria dos casos de uso com fluxo contínuo de requisições, o cache de 5 minutos oferece o melhor retorno.
Quando testei em produção, percebi que o break-even acontece muito rápido. Uma escrita mais uma leitura já custa 1.35x do preço base, contra 2x se você enviasse o mesmo conteúdo duas vezes sem cache. A partir da segunda leitura, a economia se acumula exponencialmente.
Quando o Claude Fable 5 prompt caching faz sentido
O cache compensa quando você tem conteúdo estável que se repete entre chamadas. System prompts longos são o exemplo clássico. Se o seu agente usa instruções fixas de 2.000 tokens em toda interação, você está desperdiçando dinheiro sem cache.
Outros cenários ideais incluem: documentos de referência que o modelo precisa consultar repetidamente, definições de ferramentas (tools) que não mudam entre requisições, exemplos few-shot padronizados e histórico de conversas em chatbots multi-turno. O padrão comum é que tudo antes da mensagem do usuário permanece igual.
Implementação prática: caching automático vs explícito
A API oferece duas abordagens. O caching automático é mais simples: você adiciona um campo cache_control no nível superior da requisição e o sistema gerencia os breakpoints conforme a conversa cresce. Essa é a opção recomendada para começar.
O caching explícito dá controle granular. Você posiciona cache_control diretamente em blocos de conteúdo específicos. Na prática, prefiro o explícito quando preciso cachear o system prompt independentemente do histórico de mensagens, ou quando tenho múltiplos documentos de referência com diferentes ciclos de vida.
Um detalhe técnico: você pode usar até 4 breakpoints explícitos por requisição. O caching automático consome um slot. Para estruturas complexas com múltiplas camadas de contexto, combine as duas abordagens — breakpoint explícito no system prompt e automático para o restante da conversa.
O mínimo cacheável no Claude Fable 5 é 1.024 tokens. Prompts menores que isso não entram no cache. Se seu system prompt tem 500 tokens, não adianta tentar cachear — a economia simplesmente não vai acontecer.
Erros comuns que invalidam o cache
Esse é o ponto onde muita gente perde dinheiro. O cache funciona por correspondência exata de prefixo. Qualquer alteração no início do prompt invalida tudo. Timestamps dinâmicos no system prompt, espaços em branco inconsistentes, IDs de usuário no cabeçalho das instruções — todos esses padrões destroem a taxa de cache hit.
Outro erro frequente: trocar de modelo no meio da sessão. A cache é vinculada à versão específica do modelo. Se você alterna entre Fable 5 e Opus 4.8, perde o cache acumulado. Adicionar uma ferramenta MCP durante a conversa também pode invalidar o prefixo inteiro, multiplicando seus custos em 5x naquele turno.
Calculando economia real com Claude Fable 5 prompt caching
Vamos aos números concretos. Considere um chatbot de suporte que processa 10.000 conversas por mês. Cada conversa tem em média 5 turnos. O system prompt tem 3.000 tokens. Sem cache, você processa 3.000 × 5 × 10.000 = 150 milhões de tokens de system prompt por mês. A $10/milhão, são $1.500 só nessa parte.
Com Claude Fable 5 prompt caching implementado corretamente, a primeira chamada de cada sessão paga escrita ($12.50/milhão), mas as próximas 4 pagam leitura ($1/milhão). O custo do system prompt cai para aproximadamente $165 mensais. Economia de quase 90%.
A regra prática que funciona: se você faz mais de 3 leituras dentro da janela de TTL para cache de 5 minutos, ou mais de 5 leituras para cache de 1 hora, está economizando dinheiro. Abaixo disso, o custo de escrita pode não compensar.
Monitoramento e otimização contínua
Implementar o cache é só o primeiro passo. Você precisa monitorar a taxa de cache hit no seu dashboard de observabilidade. A API retorna métricas de uso que mostram quantos tokens vieram do cache versus processamento normal. Se sua taxa de hit está abaixo de 80%, algo está quebrando o prefixo.
As equipes mais eficientes que conheço auditam os prompts regularmente buscando os anti-padrões já mencionados: timestamps, contextos de usuário variáveis e espaços inconsistentes. Corrigir esses detalhes pode dobrar sua economia sem nenhuma mudança de arquitetura. A ModoDev recomenda criar alertas automáticos quando a taxa de hit cair abaixo de um threshold aceitável.
Limitações e considerações finais sobre cache no Fable 5
Preciso ser direto: o Claude Fable 5 prompt caching não reduz custos de output. Tokens gerados pelo modelo continuam sendo cobrados no preço normal de $50/milhão. Se sua aplicação gera respostas longas — relatórios, código extenso, artigos — os tokens de saída vão dominar sua conta independentemente do cache.
Também existe uma limitação prática de TTL. Se seu fluxo de trabalho tem gaps maiores que 5 minutos entre requisições, você vai pagar escritas frequentes. Para workloads com uso esporádico, a economia pode ser marginal. E workloads de baixa reutilização com cache de 1 hora podem até perder dinheiro pelo custo de escrita de 2x.
Minha opinião: para quem trabalha com agentes autônomos, chatbots de alto volume ou aplicações que processam documentos longos repetidamente, o cache é obrigatório. Não implementar é jogar dinheiro fora. Mas para scripts únicos ou análises pontuais sem repetição de contexto, o overhead de configuração pode não justificar. Avalie seu padrão de uso antes de investir tempo na implementação.
Avalie este artigo
Continue lendo
 Inteligência Artificial
Claude Fable 5 para Análise de Contratos Jurídicos
Baseado nas pesquisas realizadas, agora tenho informações suficientes sobre o Claude Fable 5 e suas capacidades para análise de documentos jurídicos. Vou criar…
 Inteligência Artificial
Prompts para Claude IA: 50 Exemplos Práticos
Criar comandos eficientes para inteligência artificial exige técnica e conhecimento das capacidades de cada modelo. Os prompts para Claude IA funcionam como…
 Inteligência Artificial
Claude IA vs ChatGPT: Qual a Melhor Escolha em 2026
Escolher entre duas inteligências artificiais de alto nível exige análise criteriosa. O embate Claude IA vs ChatGPT domina discussões entre desenvolvedores,…
Comentários
Carregando comentários...