Claude Fable 5 para Agentes Autônomos de IA
O Claude Fable 5 agentes autônomos representa uma mudança real no modo como desenvolvedores e equipes de tecnologia podem delegar tarefas complexas para a inteligência artificial. Diferente de modelos anteriores que exigiam supervisão constante, essa versão da Anthropic foi projetada para operar de
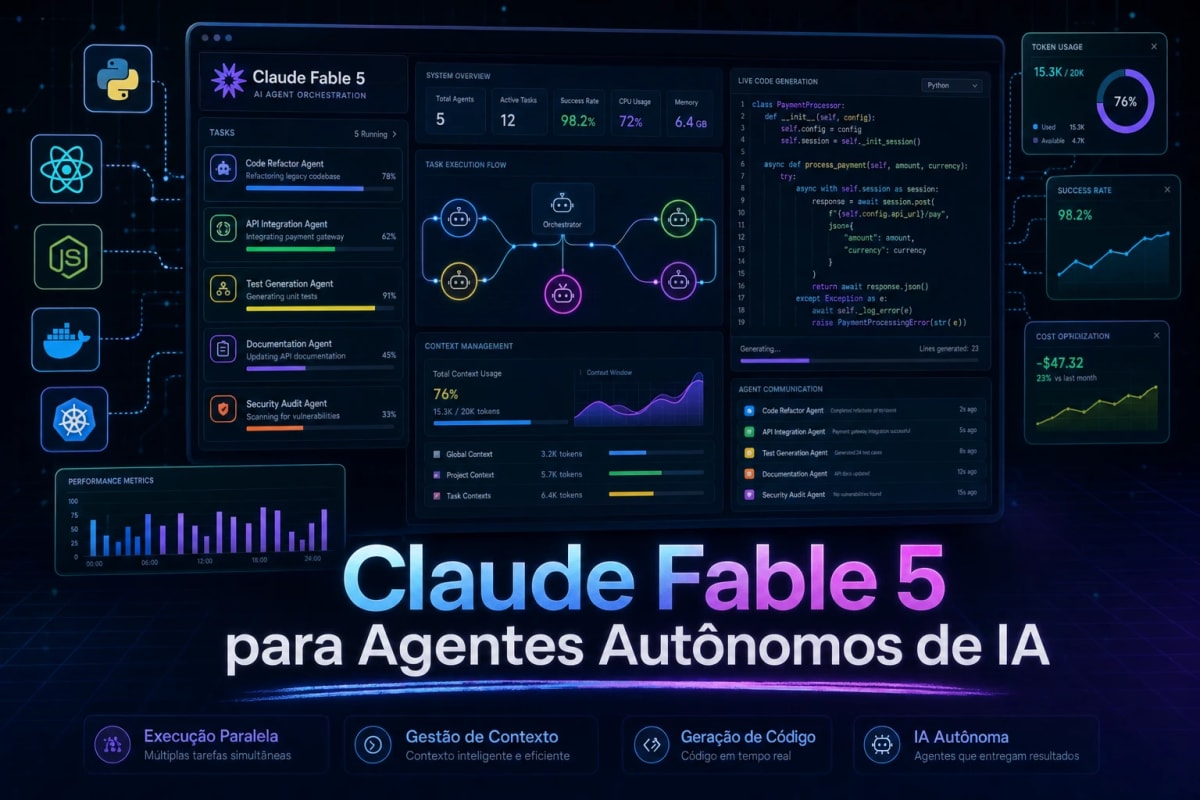
O Claude Fable 5 agentes autônomos representa uma mudança real no modo como desenvolvedores e equipes de tecnologia podem delegar tarefas complexas para a inteligência artificial. Diferente de modelos anteriores que exigiam supervisão constante, essa versão da Anthropic foi projetada para operar de forma independente por horas ou até dias, executando fluxos de trabalho que antes demandavam acompanhamento humano contínuo. Quem busca entender como esse modelo funciona dentro de harnesses de agentes pode conferir o Claude Fable 5: Guia Completo para uma visão mais ampla das capacidades do sistema.
A proposta aqui é explorar como o Fable 5 se comporta em cenários de execução prolongada. Vamos entender o que muda na prática quando você coloca um agente para rodar tarefas autônomas que levam mais do que alguns minutos para serem concluídas.
O que define o Claude Fable 5 como modelo para agentes autônomos
O Fable 5 pertence à classe Mythos da Anthropic e foi construído com foco específico em trabalho de conhecimento autônomo e codificação. A janela de contexto de 1 milhão de tokens permite que o modelo processe bases de código inteiras, centenas de documentos de pesquisa ou projetos extensos em uma única sessão. Isso elimina a fragmentação que limitava modelos anteriores em tarefas longas.
Além do contexto expandido, o modelo oferece um limite de saída de 128 mil tokens. Na prática, isso significa que ele consegue gerar módulos completos de software, documentação técnica extensa ou relatórios detalhados sem truncar o resultado. Quando testei projetos de migração de código legado, essa capacidade fez diferença real no fluxo de trabalho.
O modelo também incorpora loops de auto-verificação. Ele usa capacidades de visão para checar seu próprio código gerado, especialmente em interfaces de usuário e simulações visuais. Essa característica reduz a necessidade de revisão humana em cada etapa do processo.
Como funciona a execução em harnesses de agentes
Um agent harness é a infraestrutura que envolve o modelo e coordena sua execução em tarefas de longa duração. O Claude Agent SDK oferece recursos como compactação automática de contexto, que resume e substitui partes antigas da conversa quando o limite se aproxima. Isso permite que o agente trabalhe por períodos arbitrariamente longos sem travar por falta de espaço.
Na prática, o modelo consegue planejar sua abordagem, verificar progresso contra objetivos definidos e refinar seu trabalho conforme avança. Ele não fica esperando a próxima instrução para cada micro-decisão. Isso muda completamente o que equipes podem pedir para a IA fazer.
O harness também gerencia a comunicação entre agentes quando você usa sistemas multi-agente. Um agente pode escrever arquivos que outro agente lê e responde, criando fluxos de trabalho colaborativos entre diferentes instâncias do modelo. A delegação para sub-agentes acontece de forma coordenada, mantendo coerência mesmo em projetos que duram dias.
Cenários reais de uso prolongado com Claude Fable 5 agentes autônomos
Refatoração de código em larga escala é onde o Fable 5 mais se destaca. Projetos de migração de frameworks que antes demandavam semanas de trabalho humano agora podem ser delegados ao modelo com checkpoints de verificação. A Stripe documentou uma migração de 50 milhões de linhas usando esse tipo de pipeline agentic.
Pesquisa profunda e síntese de documentos também se beneficiam. O modelo consegue processar centenas de papers acadêmicos, extrair insights relevantes e produzir análises consolidadas prontas para revisão. Para equipes de P&D, isso acelera significativamente ciclos de pesquisa.
Automação de fluxos financeiros representa outro caso de uso relevante. Análise de investimentos, revisão de balanços, avaliação de risco e suporte a compliance podem rodar de forma autônoma, incluindo interpretação de números em arquivos longos e seus anexos. Na minha experiência, tarefas de análise que levavam horas para fazer manualmente agora completam em minutos com supervisão mínima.
Desenvolvimento de aplicações completas em uma única sessão também é possível. O que antes exigia centenas de prompts para construir, o Fable 5 consegue entregar em uma única passagem quando a especificação está bem definida. Isso não significa que qualquer prompt vago vai funcionar, mas especificações claras rendem resultados surpreendentes.
Criação de ambientes 3D e simulações com física complexa demonstra a versatilidade do modelo. Ele pode gerar simulações WebGL ou C++ com colisores e dinâmica de fluidos a partir de prompts únicos, verificando visualmente a saída contra os designs originais.
Gerenciamento de contexto em sessões longas
A compactação de contexto resolve parte do problema de tarefas extensas, mas não é suficiente sozinha. Modelos anteriores como o Sonnet 4.5 apresentavam comportamento de ansiedade de contexto quando sentiam o limite se aproximando. Eles tendiam a encerrar tarefas prematuramente ou declarar o trabalho completo antes de realmente terminar.
A solução envolve resets de contexto estratégicos no harness. Diferente da compactação, que resume a conversa para o mesmo agente continuar, o reset oferece uma tábula rasa. O custo é que o artefato de handoff precisa conter estado suficiente para o próximo agente retomar o trabalho de forma limpa. A Anthropic descobriu que esse comportamento problemático sumiu no Opus 4.5 e nos modelos subsequentes, tornando os resets menos necessários.
Arquivos de progresso funcionam como memória persistente entre sessões. Um arquivo claude-progress.txt junto com o histórico do git permite que agentes entendam rapidamente o estado do trabalho quando iniciam com uma janela de contexto nova. Isso imita o que engenheiros de software eficientes fazem diariamente.
Limitações e pontos de atenção do Claude Fable 5 agentes autônomos
O modelo não consegue se conectar automaticamente a regras de acesso específicas da empresa ou identidades de usuários reais. Ele pode gerar sistemas de login customizados desconectados de diretórios corporativos, criando potenciais problemas de segurança. Integração com plataformas como Retool ajuda a mitigar isso através de SSO, controle de acesso baseado em papéis e logs de auditoria.
Custos podem escalar rapidamente em sessões longas. Uma sessão autônoma de 30 minutos com uso intensivo de ferramentas gera volumes significativos de tokens. A recomendação prática é usar Claude Sonnet para tarefas que cabem em um único turno ou menos de cinco passos, e escalar para Fable 5 apenas quando a tarefa exigir mais de dez passos autônomos ou quando erros tiverem consequências sérias.
Minha opinião direta sobre isso: o custo premium de 2x em relação ao Opus se justifica quando as tarefas são complexas, multi-arquivo e envolvem consequências reais de erro. Para trabalho rotineiro, é desperdício de recursos.
Arquitetura de harness para máxima eficiência
O design de pipeline com checkpoints supera a abordagem de prompt único gigante. Cada fase deve produzir uma saída verificável antes da próxima começar. Isso limita o raio de explosão quando algo dá errado e oferece visibilidade sobre onde o modelo está gastando tempo.
Um sistema de três agentes funciona bem para desenvolvimento de aplicações: um inicializador que configura o ambiente com listas de features, repositórios git e arquivos de rastreamento de progresso; um agente de geração que implementa contra contratos acordados; e um agente de QA que valida o trabalho com contexto fresco, sem ter visto o processo de build.
O comando /goal do Claude Code oferece um loop gerador/avaliador pronto para uso. Você define uma condição de conclusão e um modelo separado verifica após cada turno até que a condição seja atendida. O repositório cwc-long-running-agents da Anthropic disponibiliza os mesmos primitivos como hooks legíveis e subagentes customizáveis.
Testes automatizados funcionam como guardrails. Coding autônomo funciona melhor quando o modelo pode verificar seu próprio trabalho. Uma suíte de testes passando é a barreira que captura erros antes de você vê-los. Sempre trabalhe em branches e deixe o modelo commitar após cada passo lógico para revisão e reversão quando necessário.
Comparativo de comportamento entre modelos em tarefas longas
A diferença entre Fable 5 e modelos anteriores cresce conforme a complexidade da tarefa aumenta. Em geração de função simples, Fable 5 é talvez 10-15% melhor que Opus. Em refatorações multi-arquivo com mudanças de tipo em cascata e atualizações de testes, Fable 5 opera em outro patamar completamente.
O benchmark de Senior Engineer mostra 91/100 para Fable 5 contra 63 para Opus. Não é apenas um número em relatório. Reflete uma diferença real em como esses modelos mantêm coerência em cadeias de raciocínio estendidas. Todo LLM degrada conforme a complexidade aumenta, mas o Fable 5 degrada muito mais lentamente.
Opus 4.8 continua relevante para trabalho complexo de raciocínio e coding agentic de longo prazo. A forma correta de usar Fable 5 em produção não é como modelo padrão para tudo, mas como modelo de escalonamento para trabalho sério. Para quem busca mais informações sobre ferramentas de IA e desenvolvimento, o ModoDev oferece conteúdos atualizados sobre o tema.
Estratégias práticas para implementação de Claude Fable 5 agentes autônomos
Prepare seu ambiente antes de iniciar sessões autônomas. Não seja vago nas instruções. Dizer para tornar o app mais rápido produz resultados dispersos. Especificar otimização de endpoint com tempo de resposta abaixo de 200ms através de índices de banco e cache de resposta dá ao modelo um alvo claro.
Configure contextos que incluam automaticamente arquivos relevantes para tipos específicos de tarefa. Com Claude Code routines, isso fica padronizado e consistente entre execuções. A preparação inicial economiza tempo e tokens nas sessões subsequentes.
Scripts leves podem orquestrar tarefas sequenciais alimentando o CLI do Claude. Isso garante que cada tarefa comece com janela de contexto fresca, evitando a deriva que acontece após cerca de uma hora de trabalho contínuo. O resultado é um workflow estruturado que suporta projetos autônomos de longo prazo com supervisão mínima.
Avalie este artigo
Continue lendo
 Inteligência Artificial
Claude Fable 5 para Análise de Contratos Jurídicos
Baseado nas pesquisas realizadas, agora tenho informações suficientes sobre o Claude Fable 5 e suas capacidades para análise de documentos jurídicos. Vou criar…
 Inteligência Artificial
Prompts para Claude IA: 50 Exemplos Práticos
Criar comandos eficientes para inteligência artificial exige técnica e conhecimento das capacidades de cada modelo. Os prompts para Claude IA funcionam como…
 Inteligência Artificial
Claude IA vs ChatGPT: Qual a Melhor Escolha em 2026
Escolher entre duas inteligências artificiais de alto nível exige análise criteriosa. O embate Claude IA vs ChatGPT domina discussões entre desenvolvedores,…
Comentários
Carregando comentários...