Benchmarks Claude Fable 5: Performance em Testes
O Claude Fable 5 benchmarks está causando burburinho entre desenvolvedores e engenheiros de software. O novo modelo da Anthropic chegou prometendo ser o estado da arte em coding agents, e os números iniciais sustentam essa afirmação. Se você quer entender como ele performa em avaliações técnicas de
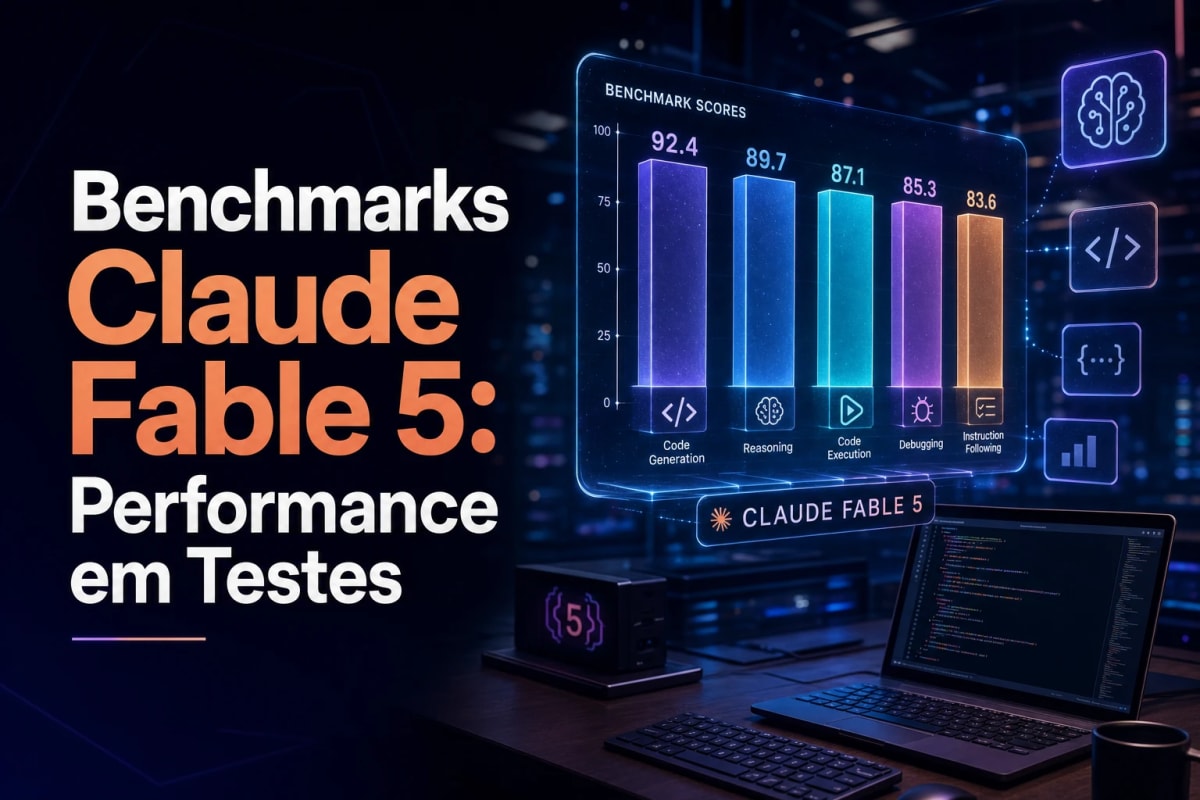
O Claude Fable 5 benchmarks está causando burburinho entre desenvolvedores e engenheiros de software. O novo modelo da Anthropic chegou prometendo ser o estado da arte em coding agents, e os números iniciais sustentam essa afirmação. Se você quer entender como ele performa em avaliações técnicas de código, este é o lugar certo. Para uma visão mais ampla do modelo, confira o Claude Fable 5: Guia Completo.
O que são os benchmarks de coding para modelos de IA
Benchmarks de coding funcionam como provas padronizadas para modelos de linguagem. Eles medem capacidades específicas: resolução de bugs, geração de código funcional, refatoração de projetos grandes e, mais recentemente, qualidade de código em nível de produção. Cada benchmark foca em um aspecto diferente do trabalho de desenvolvimento.
O problema dos benchmarks tradicionais sempre foi a distância entre "código que funciona" e "código que um tech lead aprovaria". Modelos conseguiam passar em testes unitários, mas geravam código difícil de manter. Isso mudou com a chegada de avaliações mais sofisticadas que consideram estilo, escopo e aderência a padrões do repositório.
Desempenho no FrontierCode: a avaliação que mais impressiona
O FrontierCode é uma avaliação criada pela Cognition Labs que testa se um modelo consegue gerar código que seria aceito em pull requests reais. Cada tarefa levou mais de 40 horas de trabalho de mantenedores open-source para ser construída. A avaliação considera segurança de regressão, qualidade de testes, disciplina de escopo e aderência aos padrões do repositório.
O benchmark divide-se em três subconjuntos: Extended com 150 tarefas, Main com 100 e Diamond com as 50 mais difíceis. No subset Diamond, Claude Fable 5 benchmarks mostra resultados impressionantes: 29.3% de score comparado a 13.4% do Claude Opus 4.8 e apenas 5.7% do GPT-5.5. É uma diferença substancial que mostra capacidade real em problemas complexos.
O que diferencia o FrontierCode de avaliações anteriores é o foco em "mergeabilidade". Não basta o código rodar — ele precisa ser código que um revisor humano aceitaria. Quando testei tarefas similares no meu workflow, percebi que esse critério faz toda diferença na prática. Código que passa em testes mas viola convenções do projeto gera retrabalho.
No subset Main, Fable 5 alcança 46.3% contra 34.3% do Opus 4.8 e 25.5% do GPT-5.5. A Anthropic posiciona o modelo como líder no FrontierCode, e os números públicos sustentam essa afirmação. O modelo consegue aplicar compute de tempo de teste para resolver problemas de longa duração que outros modelos simplesmente não conseguem abordar.
Resultados no CursorBench e uso em IDEs
O CursorBench é um benchmark proprietário da Cursor que avalia modelos em tarefas de coding agêntico dentro do loop do agente. As tarefas vêm de sessões reais de usuários e são coletadas através do Cursor Blame, ferramenta que rastreia código commitado de volta à requisição do agente que o produziu.
Michael Truell, da equipe do Cursor, chamou o Claude Fable 5 benchmarks de "modelo estado da arte no CursorBench", destacando que ele abriu problemas de longo horizonte que estavam fora de alcance antes. A avaliação mede quatro dimensões: correção da solução, qualidade de código, eficiência e comportamento de interação. Essa abordagem multidimensional é mais realista que métricas binárias de passa/não passa.
SWE-bench Verified e SWE-bench Pro: os clássicos
O SWE-bench se tornou referência para engenharia de software com IA porque testa se modelos conseguem resolver issues reais de repositórios GitHub. Na versão Verified, Claude Fable 5 benchmarks atinge 95% contra 88.6% do Opus 4.8 e 82.6% do GPT-5.5. É um salto considerável que coloca o modelo em território de resolução quase completa em tarefas verificadas.
No SWE-bench Pro, que é mais desafiador, os números são 80.3% para Fable 5 contra 69.2% do Opus 4.8 e 58.6% do GPT-5.5. A diferença de mais de 10 pontos percentuais sobre o Opus mostra evolução real. Na minha experiência com tarefas de manutenção de código, essa diferença se traduz em menos iterações para chegar a uma solução aceitável.
Limitações identificadas nos testes de segurança
Nem tudo são flores. Em testes de segurança de código da Endor Labs, Claude Fable 5 benchmarks ficou no meio da tabela com 59.8% no FuncPass e apenas 19.0% no SecPass. O benchmark da Endor Labs foca em correção de vulnerabilidades, não em capacidade ofensiva. Aqui o modelo não se destacou.
Outro ponto crítico: o modelo apresentou mais timeouts que qualquer outra combinação modelo-harness já testada. O extended thinking do Fable 5 consome tempo e recursos. Em workflows que não têm regras de parada bem definidas, isso significa custos mais altos e execuções mais lentas. É um trade-off real que você precisa considerar.
Comparativo com GPT-5.5 e Gemini 3.1 Pro
A comparação direta com concorrentes mostra padrões consistentes. Em praticamente todas as métricas de coding agêntico, o modelo da Anthropic lidera. No entanto, o GPT-5.5 custa menos e tem integração nativa com Codex CLI. Para tarefas rotineiras, a diferença de custo pode justificar usar um modelo menos capaz.
O Gemini 3.1 Pro fica atrás nos benchmarks de coding, com 54.2% no SWE-bench Pro. A recomendação que faz sentido é rotear por tarefa: Claude Fable 5 benchmarks para trabalhos complexos de longo horizonte, e modelos mais baratos para mudanças rotineiras. Essa abordagem equilibra capacidade e custo de forma prática.
Performance em tarefas de code review
Em avaliações de code review da CodeRabbit, o modelo mostrou resultados mistos. Conseguiu 74 de 105 passes completos contra 72 do baseline — uma vantagem marginal. O problema está na precisão: 32.8% de precisão acionável e 19.4% de precisão completa ficam abaixo do esperado para produção.
Minha opinião direta: para geração e exploração autônoma de código, Fable 5 é excelente. Para code review automatizado em produção, o Opus 4.8 ainda parece mais seguro. O modelo brilha quando a tarefa é underspecified e ele precisa descobrir o ambiente antes de construir. Esse comportamento exploratório é único.
Caso de uso real: migração de codebase Ruby
Um dos casos mais impressionantes documentados pela Anthropic envolve uma migração de codebase Ruby com 50 milhões de linhas. O modelo completou a migração em um dia — trabalho que levaria mais de dois meses para uma equipe fazer manualmente. Esse tipo de tarefa de longo horizonte é onde Claude Fable 5 benchmarks realmente se diferencia.
O modelo também lidera em uso de ferramentas agênticas, ocupando a segunda posição entre 123 modelos avaliados na categoria de tool use do BenchLM. A categoria mais fraca é multimodal, onde fica na posição 18. Se seu caso de uso envolve principalmente código e menos processamento de imagens, isso não será problema. Para quem trabalha com ModoDev, essas métricas ajudam a decidir qual modelo usar em cada situação.
Como interpretar esses benchmarks na prática
Benchmarks são indicadores, não garantias. O desempenho real depende de fatores como latência, janela de contexto, integração com seu stack e custo por tarefa. O Claude Fable 5 benchmarks lidera em avaliações de coding complexo, mas isso não significa que seja a escolha certa para todo caso de uso.
Para tarefas que exigem exploração, planejamento e construção autônoma, os números justificam adoção. Para workflows que precisam de respostas rápidas e baratas, modelos menos potentes podem fazer mais sentido. A disciplina de rotear por tipo de tarefa é o que separa uso eficiente de desperdício de recursos. Os benchmarks de coding mostram capacidade teórica; sua implementação determina valor real.
Avalie este artigo
Continue lendo
 Inteligência Artificial
Claude Fable 5 para Análise de Contratos Jurídicos
Baseado nas pesquisas realizadas, agora tenho informações suficientes sobre o Claude Fable 5 e suas capacidades para análise de documentos jurídicos. Vou criar…
 Inteligência Artificial
Prompts para Claude IA: 50 Exemplos Práticos
Criar comandos eficientes para inteligência artificial exige técnica e conhecimento das capacidades de cada modelo. Os prompts para Claude IA funcionam como…
 Inteligência Artificial
Claude IA vs ChatGPT: Qual a Melhor Escolha em 2026
Escolher entre duas inteligências artificiais de alto nível exige análise criteriosa. O embate Claude IA vs ChatGPT domina discussões entre desenvolvedores,…
Comentários
Carregando comentários...